Lift, Splat, Shoot Encoding Images From Arbitrary Camera Rigs by Implicitly Unprojecting to 3D
记录论文《Lift, Splat, Shoot: Encoding Images From Arbitrary Camera Rigs by Implicitly Unprojecting to 3D》阅读过程中的一些思考。
简介
LSS 通过学习逐像素深度概率分布,首次实现了从任意多视角图像到 BEV 表示的端到端可微转换,解决了多相机数据对齐和场景理解中的遮挡问题,是 BEV 感知领域的开山之作。

LSS 方法的核心是独立地将各相机的图像提升(lift)到各自的特征视锥(frustum of features),然后将这些特征视锥都溅射(splat)到一个光栅化(rasterized)的鸟瞰图网格(bird's-eye-view grid)中,最后将模板轨迹投射(shoot)到网络输出的鸟瞰代价地图(cost map),这证实了模型学到的密集表示能够支持可解释的端到端运动规划(motion planning)。
传统计算机视觉算法的输出通常是坐标系无关的(如分类),或与输入图像一个坐标系的预测(如目标检测、语义分割和全景分割)。这与自动驾驶中感知模型从来自不同坐标系的多传感器接受输入并处理成一个新的基于自车坐标系的预测输出,以供下游规划模块使用的范式不匹配,参考下图。

有多种简单实用的策略可以将单图像处理范式扩展到多图像处理领域,如先将单图像检测器分别应用到所有输入图像,再结合各自内外参将检测结果转到自车坐标系。这类拓展方法有三个重要对称特性:
平移等变性(Translation equivariance):如果平移图像中所有的像素坐标,那么输出将平移相同的量。全卷积单图像目标检测器基本具备该性质,而多图像扩展版本也继承了这一性质。置换不变性(Permutation invariance):最终输出与这些相机的顺序无关自车坐标系等距等变性(Ego-frame isometry equivariance):无论捕获这张图像的相机与主车的相对位置如何,这张图像都会检出同样的目标。换句话说,平移或旋转自车坐标系,那输出也会相应的平移或旋转。
这种简单方法存在的问题是,对单图像检测器使用后处理会阻断自车坐标系下的预测一直回传到传感器输入的微分(梯度)链路。因此,模型无法以数据驱动的方式学习跨相机融合信息的最佳方式。这同样意味着无法基于反向传播利用下游规划器的反馈自动提升感知系统。
而本文提出的方法不仅保留了上述 $3$ 个对称特性,而且满足端到端可微。
概念
约定
给定 $n$ 个图像 $\left\{X_k \in \mathbb{R}^{3 \times H \times W}\right\}_n$ ,它们各自有外参 $E_k \in \mathbb{R}^{3 \times 4}$ 和内参 $I_k \in \mathbb{R}^{3 \times 3}$ ,内外参矩阵共同定义了从参考坐标系 $(x,y,z)$ 到局部像素坐标系 $(h,w,d)$ 的映射。本文就是要在 BEV 坐标系 $y \in \mathbb{R}^{C \times X \times Y}$ 内找到场景的光栅化表达。
提升 / Lift:潜在深度分布(Latent Depth Distribution)
Lift 单独将每个相机的图像从(相机)局部坐标系“提升”到所有相机共享的三维坐标系。这一步的难点在于转换到三维坐标系需要深度信息而单目相机图像像素的深度是模糊不定的,为此,Lift 创新地为每个像素生成所有可能深度的表示。
对于其中一个外参为 $E$ ,内参为 $I$ 的图像 $X$ ,其中的像素 $p$ 在像素坐标系下的坐标为 $(h,w)$ 。
首先为每个像素关联 $|D|$ 个点 $\left\{(h,w,d)\in\mathbb{R}^3\,|\,d\in D \right\}$ ,其中 $D$ 是一组定义为 $\left\{d_0+\Delta,\dots,d_0+|D|\Delta\right\}$ 的离散深度。注意,该变换没有可学习的参数,只是为给定图像简单地创建了一个尺寸为 $D\cdot H\cdot W$ 的大点云。这相当于多视图合成(multi-view synthesis)中的多平面图像(multi-plane image, MPI),只是这里每个平面的特征是抽象的(经过 backbone 输出的特征)向量,而不是真正的 $(r,g,b,\alpha)$ 像素值。
点云中每个点的上下文特征向量是被参数化来匹配注意力和离散深度推理的概念。网络为每个像素 $p$ 预测一个上下文特征向量 $\boldsymbol{c}\in\mathbb{R}^C$ 和一个深度分布向量 $\alpha\in\Delta^{|D|-1}$ 。而点 $p_d$ 对应的特征向量 $\boldsymbol{c}_d\in\mathbb{R}^C$ 是通过像素 $p$ 共享的上下文向量缩放得到,即
$$\boldsymbol{c}_d = \alpha_d\boldsymbol{c}$$
网络对深度分布向量 $\alpha$ 的预测结果分两种情形:
独热(one-hot)向量:类似于伪激光雷达,仅在单个深度 $d^*$ 处的上下文特征向量非零- (深度上)
均匀分布向量:类似于OFT,所有深度点处的上下文特征向量全部相同,即与深度无关
因此,网络在理论上能够在将上下文特征向量放在 BEV 表达下的指定位置或者(在深度信息模糊时)将上下文特征向量在整个空间射线中传播之间做出选择。
总的来说,Lift 就是对于每幅图像生成一个函数(映射) $g_c:(x,y,z) \in \mathbb{R}^3 \rightarrow c \in \mathbb{R}^C$ 使得在任意空间位置都可以查询得到一个上下文特征向量,这一过程如下图所示

衡准
范例
class BaseTransform(nn.Module):

    def __init__(...):
        ...
        self.frustum = self.create_frustum()
        ...

    @force_fp32()
    def create_frustum(self):
        iH, iW = self.image_size
        fH, fW = self.feature_size

        ds = (
            torch.arange(*self.dbound, dtype=torch.float)  # 按起、终点及步长生成深度序列
            .view(-1, 1, 1)  # 在图像宽、高方向插入维度
            .expand(-1, fH, fW)  # 在宽、高维度广播数据(不复制仅引用)
        )
        D, _, _ = ds.shape

        xs = (
            torch.linspace(0, iW - 1, fW, dtype=torch.float)
            .view(1, 1, fW)
            .expand(D, fH, fW)
        )
        ys = (
            torch.linspace(0, iH - 1, fH, dtype=torch.float)
            .view(1, fH, 1)
            .expand(D, fH, fW)
        )

        frustum = torch.stack((xs, ys, ds), -1)  # 堆叠为 D x H x W x 3
        return nn.Parameter(frustum, requires_grad=False)

    @force_fp32()
    def get_geometry(
        self,
        camera2lidar_rots,
        camera2lidar_trans,
        intrins,
        post_rots,
        post_trans,
        **kwargs,
    ):
        B, N, _ = camera2lidar_trans.shape

        # undo post-transformation
        ## undo translation
        ## 此处存在维度广播:(D, H, W, 3) - (B, N, 1, 1, 1, 3) -> (B, N, D, H, W, 3)
        points = self.frustum - post_trans.view(B, N, 1, 1, 1, 3)
        ## undo rotation
        ## 使用 unsqueeze 在最后插入新维度以右对齐,再做矩阵乘法
        ## (B, N, 1, 1, 1, 3, 3) x (B, N, D, H, W, 3, 1) -> (B, N, D, H, W, 3, 1)
        points = (
            torch.inverse(post_rots)
            .view(B, N, 1, 1, 1, 3, 3)
            .matmul(points.unsqueeze(-1))
        )
        # cam_to_lidar
        # formula reference: https://review.yirami.xyz/academic/camera_calibration/#4-%E5%9D%90%E6%A0%87%E7%B3%BB%E8%BD%AC%E6%8D%A2
        points = torch.cat(
            (
                points[:, :, :, :, :, :2] * points[:, :, :, :, :, 2:3],
                points[:, :, :, :, :, 2:3],
            ),
            5,
        )  # (B, N, D, H, W, 3, 1)
        combine = camera2lidar_rots.matmul(torch.inverse(intrins))  # (B, N, 3, 3) x (B, N, 3, 3)
        points = combine.view(B, N, 1, 1, 1, 3, 3).matmul(points).squeeze(-1)  # (B, N, 1, 1, 1, 3, 3) x (B, N, D, H, W, 3, 1) -> (B, N, D, H, W, 3)
        points += camera2lidar_trans.view(B, N, 1, 1, 1, 3)  # (B, N, D, H, W, 3)

        # apply lidar augmentation transform
        ## rotation
        if "extra_rots" in kwargs:
            extra_rots = kwargs["extra_rots"]
            points = (
                extra_rots.view(B, 1, 1, 1, 1, 3, 3)
                .repeat(1, N, 1, 1, 1, 1, 1)
                .matmul(points.unsqueeze(-1))
                .squeeze(-1)
            )
        ## translation
        if "extra_trans" in kwargs:
            extra_trans = kwargs["extra_trans"]
            points += extra_trans.view(B, 1, 1, 1, 1, 3).repeat(1, N, 1, 1, 1, 1)

        return points  # (B, N, D, H, W, 3)

    @force_fp32()
    def forward(...):
        ...
        # rots = camera2ego[..., :3, :3]
        # trans = camera2ego[..., :3, 3]
        intrins = camera_intrinsics[..., :3, :3]
        post_rots = img_aug_matrix[..., :3, :3]
        post_trans = img_aug_matrix[..., :3, 3]
        # lidar2ego_rots = lidar2ego[..., :3, :3]
        # lidar2ego_trans = lidar2ego[..., :3, 3]
        camera2lidar_rots = camera2lidar[..., :3, :3]
        camera2lidar_trans = camera2lidar[..., :3, 3]

        extra_rots = lidar_aug_matrix[..., :3, :3]
        extra_trans = lidar_aug_matrix[..., :3, 3]

        geom = self.get_geometry(
            camera2lidar_rots,
            camera2lidar_trans,
            intrins,
            post_rots,
            post_trans,
            extra_rots=extra_rots,
            extra_trans=extra_trans,
        )  # (B, N, D, H, W, 3)

@VTRANSFORMS.register_module()
class LSSTransform(BaseTransform):

    def __init__(...):
        super().__init__(...)
        # 此处使用同一卷积网络将 D 和 C 合并输出,即
        # ... 分别取前 D 个通道为深度分布预测,后 C 个通道为特征预测,是为了
        # ... 让深度预测和特征预测进行共享和交互,使得
        # 1. 某个区域的特征有助于预测深度
        # 2. 深度信息反过来能改善特征表示
        # 此外,从使用上看,学习深度分布是为了**加权**特征,不是独立使用的估计
        self.depthnet = nn.Conv2d(in_channels, self.D + self.C, 1)
        ...

    @force_fp32()
    def get_cam_feats(self, x):
        B, N, C, fH, fW = x.shape

        # 将 B, N 看作一个维度,因为后续 nn.Conv2d() 的 `Tensor` 参数只接受 4 维
        #
        # nn.Conv2d() 在语义上是对输入 (B, C, H, W) 在
        # ... 1. 在空间维度 (H, W) 上应用相同的卷积核
        # ... 2. 在样本维度 (C, H, W) 上应用相同的参数
        # 此处将 B 和 N 看作一体,符合语义
        x = x.view(B * N, C, fH, fW)

        # nn.Module 中在 __call__() 中调用了 self.forward()
        x = self.depthnet(x)  # (B x N, D + C, H, W)
        # do softmax for depth prediction
        depth = x[:, : self.D].softmax(dim=1)  # (B x N, D, H, W)
        # calculate the weighted features
        x = depth.unsqueeze(1) * x[:, self.D : (self.D + self.C)].unsqueeze(2)  # (B x N, 1, D, H, W) x (B x N, C, 1, H, W) -> (B x N, C, D, H, W)

        x = x.view(B, N, self.C, self.D, fH, fW)  # (B, N, C, D, H, W)
        x = x.permute(0, 1, 3, 4, 5, 2)  # (B, N, D, H, W, C)
        return x
探微
Q1: 深度分布 $\alpha\in\Delta^{|D|-1}$ 的含义是什么?
A:记号 $\Delta^{|D|-1}$ 是数学中的概率单纯形(Probability Simplex),是指 $|D|$ 维空间中,所有分量非负且分量之和为 $1$ 的向量集合,即
$$\Delta^{|D|-1} = \left\{ \alpha \in \mathbb{R}^{|D|} \;\middle|\; \alpha_d \geq 0,\; \sum_{d=1}^{|D|} \alpha_d = 1 \right\}$$
如 $|D|=41$ ,则 $\alpha$ 为一个 $41$ 维向量,其通常是一个由 softmax 得到的表示该像素在 $41$ 个离散深度值上的概率分布。
Q2: 深度点 $p_d$ 的特征向量 $\boldsymbol{c}_d = \alpha_d\boldsymbol{c}$ 有什么含义?
A:与像素 $p$ 对应的指定深度的点 $p_d$ 通过概率 $\alpha_d$ 加权该像素共享的上下文特征向量,通过学习,让真实深度处点的特征向量趋近上下文特征向量 $\boldsymbol{c}$ ,从而将特征“放”在了正确的三维位置。
Q3: LSS 是如何在有限的 $|D|$ 上平衡深度的范围与精度?
从 $D$ 的集合定义 $\left\{d_0+\Delta,\dots,d_0+|D|\Delta\right\}$ 来看,其对超出范围的目标是截断的,即直接忽略。通过调整 $\Delta$ 的大小可以在范围和精度间取舍,通过调整 $D$ 的大小可以同时扩展范围和精度。
但 LSS 中的 $D$ 属于均匀间隔,具有明显的局限,后续有一些工作做了改进:
- 非均匀深度采样:近处密、远处疏(符合透视投影的特性——近处的深度精度比远处更重要)
BEVDepth:引入显式深度监督(用LiDAR点云作为深度真值),让深度分布预测更准确,缓解了有限 $|D|$ 下的精度问题- 自适应深度范围:根据场景动态调整 $d_0$ 和 $\Delta$
溅射 / Splat:柱状池化(Pillar Pooling)
Splat 这步借鉴 pointpillars 架构把 Lift 中得到的三维点云转换到 BEV 平面。首先,在预定的 BEV 视角范围内按照精度划分出一个个小网格,它们具有无穷的高度,也被称为体素(Voxel)。然后将 Lift 得到的三维点云按就近原则分配到各自的柱状体素中,并在体素范围内对点的特征进行求和池化(sum pooling),得到一个尺寸 $C\times X\times Y$ 的张量。最后对其施加标准卷积(CNN)操作进行推理,得到 BEV 下的特征图以用于语义分割或规划。
整个 Lift-Splat 架构流程如下图所示

衡准
范例
def gen_dx_bx(xbound, ybound, zbound):
    # delta
    dx = torch.Tensor([row[2] for row in [xbound, ybound, zbound]])
    # base ?: center of bound
    bx = torch.Tensor([row[0] + row[2] / 2.0 for row in [xbound, ybound, zbound]])
    # number
    nx = torch.LongTensor(
        [(row[1] - row[0]) / row[2] for row in [xbound, ybound, zbound]]
    )
    return dx, bx, nx

class QuickCumsum(torch.autograd.Function):
    @staticmethod
    def forward(ctx, x, geom_feats, ranks):
        # 在 Nprime 轴累积求和
        x = x.cumsum(0)
        # 标记各组最后一个元素的索引,并作为后续数据保留依据
        # 判断后一索引的 rank 与当前索引的 rank 相比是否跳变
        # ... 标记跳变处为 1 ,且最后一个值始终保留初始值 1
        kept = torch.ones(x.shape[0], device=x.device, dtype=torch.bool)
        kept[:-1] = ranks[1:] != ranks[:-1]

        # 按各组最后一个元素的索引取累积特征和相应坐标
        x, geom_feats = x[kept], geom_feats[kept]
        # 排除累积的前序组的特征
        x = torch.cat((x[:1], x[1:] - x[:-1]))

        # save kept for backward
        ctx.save_for_backward(kept)

        # no gradient for geom_feats
        ctx.mark_non_differentiable(geom_feats)

        return x, geom_feats

    @staticmethod
    def backward(ctx, gradx, gradgeom):  # PyTorch autograd 要求输入参数匹配 forward 的输出参数
        (kept,) = ctx.saved_tensors
        # 从跳变索引恢复出原始分组信息
        back = torch.cumsum(kept, 0)  # [0, 0, 1, 0, 1, 1] -> [0, 0, 1, 1, 2, 3]
        back[kept] -= 1  # [0, 0, 1, 1, 2, 3] -> [0, 0, 0, 1, 1, 2]

        # 因为 forward 中是组内求和,而 $\frac{\partial \text{sum}}{\partial x_i} = 1$
        # ... 所以 backward 中每个元素的梯度就是对应组的输出梯度
        val = gradx[back]

        return val, None, None  # 输出参数匹配 forward 的输入参数,不需要梯度的参数返回 None
        #      ↑x   ↑geom ↑ranks

def bev_pool(feats, coords, B, D, H, W):
    assert feats.shape[0] == coords.shape[0]

    # 将坐标(含批索引) $\in\mathbb{R}^4$ 映射到实数 $\mathbb{R}$ 空间,
    # ... 且满足:1)同一网格的点映射后值相等 2)不同网格的点映射后值不等
    #
    # $x \in [0, H)$
    # $y \in [0, W)$
    # $z \in [0, D)$
    # $idx \in [0, B)$
    ranks = (
        coords[:, 0] * (W * D * B)  # x
        + coords[:, 1] * (D * B)  # y
        + coords[:, 2] * B  # z
        + coords[:, 3]  # batch idx
    )
    indices = ranks.argsort()
    feats, coords, ranks = feats[indices], coords[indices], ranks[indices]

    x, geom_feats = QuickCumsum.apply(feats, coords, ranks)

    # 创建空的特征网格数据
    C = x.shape[1]
    final = torch.zeros((B, C, D, H, W), device=x.device)
    # 将聚合后的特征按照索引赋到网格(高级索引赋值)
    # 此处切片作为左值是直接写回地址
    final[geom_feats[:, 3], :, geom_feats[:, 2], geom_feats[:, 0], geom_feats[:, 1]] = x

    return final  # (B, C, D, H, W)

class BaseTransform(nn.Module):

    def __init__(...):
        ...
        dx, bx, nx = gen_dx_bx(self.xbound, self.ybound, self.zbound)
        self.dx = nn.Parameter(dx, requires_grad=False)
        self.bx = nn.Parameter(bx, requires_grad=False)
        self.nx = nn.Parameter(nx, requires_grad=False)
        ...

    @force_fp32()
    def bev_pool(self, geom_feats, x):
        B, N, D, H, W, C = x.shape
        Nprime = B * N * D * H * W

        # flatten x
        x = x.reshape(Nprime, C)  # (B x N x D x H x W, C)

        # flatten indices
        ## 将 geom_feats 的三维坐标转到三维网格中得到索引,并使用 long() 将其长整化
        geom_feats = ((geom_feats - (self.bx - self.dx / 2.0)) / self.dx).long()
        geom_feats = geom_feats.view(Nprime, 3)  # (B x N x D x H x W, 3)
        ## 为各 Batch 的数据创建 Batch 索引
        batch_ix = torch.cat(
            [
                torch.full([Nprime // B, 1], ix, device=x.device, dtype=torch.long)
                for ix in range(B)
            ]
        )  # (B x N x D x H x W, 1)
        geom_feats = torch.cat((geom_feats, batch_ix), 1)  # (B x N x D x H x W, 4)

        # filter out points that are outside box
        kept = (
            (geom_feats[:, 0] >= 0)
            & (geom_feats[:, 0] < self.nx[0])
            & (geom_feats[:, 1] >= 0)
            & (geom_feats[:, 1] < self.nx[1])
            & (geom_feats[:, 2] >= 0)
            & (geom_feats[:, 2] < self.nx[2])
        )
        x = x[kept]
        geom_feats = geom_feats[kept]

        x = bev_pool(x, geom_feats, B, self.nx[2], self.nx[0], self.nx[1])  # (B, C, D, H, W)

        # collapse Z
        # 按 D 维展开,并在 C 维上拼接(同一深度的通道相邻)
        # 等价于 permute(0, 2, 1, 3, 4).contiguous().view(B, -1, H, W)
        # 等效于 view(B, -1, H, W) ,下游可自动适应任意通道排序
        final = torch.cat(x.unbind(dim=2), 1)

        return final

    @force_fp32()
    def forward(...):
        ...
        x = self.bev_pool(geom, x)
        ...
探微
Q1: Splat 过程中分配三维点到最近的 pillar 的操作似乎不可微,为什么 LSS 模型还是端到端可微?
A:决定这个分配的参数,包括像素坐标 $(h,w)$ ,离散深度 $d$ ,相机内参 $I$ ,相机外参 $E$ 这些都是不可学习的参数,因此哪个三维点落入哪个 pillar 是前向传播前就确定好的静态映射,无需参与梯度计算。
可将该映射定义为一个稀疏指派矩阵 $A\in\{0,1\}^{P\times N}$ ,其中 $P$ 为 pillar 数,而 $N$ 为总点数,因而 $A_{p,n} = 1$ 就表示第 $n$ 个点属于第 $p$ 个 pillar ,它是一个常量矩阵。
因此,柱状池化过程亦可以用矩阵形式表达
$$\text{BEV} = A \cdot F$$
其中, $F\in\mathbb{R}^{N\times C}$ 是所有点的特征矩阵。
在反向传播时,结合其逐元素展开形式
$$\text{BEV}_{p,c} = \sum_n A_{p,n}\, F_{n,c}$$
不难得出
$$\frac{\partial \mathcal{L}}{\partial F_{n,c}} = \sum_p \frac{\partial \mathcal{L}}{\partial \text{BEV}_{p,c}} \cdot \frac{\partial \text{BEV}_{p,c}}{\partial F_{n,c}} = \sum_p A_{p,n} \cdot \frac{\partial \mathcal{L}}{\partial \text{BEV}_{p,c}}$$
写成矩阵形式,即为
$$\frac{\partial \mathcal{L}}{\partial F} = A^\top \cdot \frac{\partial \mathcal{L}}{\partial \text{BEV}}$$
Q2: Splat 的实现范例中 ranks 的映射设计有什么技巧?
求和池化的关键步骤是将同一网格中的所有特征求和,这要求快速聚合同一组内的特征点。有几种思路:
groupby风格的先分组,后求和方案add方式直接根据所属网格累加rank+cumsum方式先排序后累加
| 方案 | 思路 | 优势 | 劣势 |
|---|---|---|---|
groupby | 基于哈希将数据分组,然后组内操作在 pandas 中使用较多 | 可读性较好 | 随机访问,不利于 GPU 部署 |
add | 预分配累加空间,如 $(B,H,W,D)$ 根据坐标直接在该空间内累加特征 | 直观、易于理解 | 同一地址上的累加无法并行,需加锁 累加顺序不同可能产生浮点舍入差异 无特征的网格也会占用内存,浪费空间 数据在内存中不连续,访问效率低 |
rank+cumsum | 将坐标单射生成 rank ,并基于此排序使用 cumsum 求和并以 rank 跳变处的结果增量为组内和 | 重排后内存连续 顺序确定,累加结果一致 仅操作存在数据的网格 存在分组并行求和的基础 | 经典实现中并行度不够 增加排序和重排内存步骤 |
本文中使用上述 rank+cumsum 方案,即先将坐标单射到一维实数空间,生成 rank ,再基于该 rank 排序后重排内存。
四维坐标 $(x,y,z,idx)$ 的各维度取值范围为:$x \in [0, H), y \in [0, W), z \in [0, D), idx \in [0, B)$ ,需要构建一个单射将该四维坐标集合转到一维实数集。
可以参考进制设计,如 $v = x \times 10^2 + y \times 10^1 + z \times 10^0$ ,只要 $x,y,z$ 取值小于基数(Radix)(即 $10$ ),通过位权(Place Value)可以将不同维度的信息“调制”到一起,且互不影响。
最简单的思路是设计一个足够大的进制,比如取 $N=max(H,W,D,B)$ ,但以 $N$ 为基数显然对数值空间存在巨大浪费,在实践中也更容易越界,因此混合进制(Mixed Radix)更为合适。
对上述四维坐标,定义映射 $v=x \times (W \cdot D \cdot B) + y \times (D \cdot B) + z \times B + idx \times 1$ 。对于坐标 $(x_1,y_1,z_1,idx_1)$ 和 $(x_2,y_2,z_2,idx_2)$ ,可以证明:
若 $$x_1(W \cdot D \cdot B) + y_1(D \cdot B) + z_1 \cdot B + idx_1 = x_2(W \cdot D \cdot B) + y_2(D \cdot B) + z_2 \cdot B + idx_2$$ 则整理得 $$(x_1 - x_2)(W \cdot D \cdot B) + (y_1 - y_2)(D \cdot B) + (z_1 - z_2) \cdot B + (idx_1 - idx_2) = 0$$ 若 $x_1 \neq x_2$ ,则 $|(x_1 - x_2)(W \cdot D \cdot B)| \in \left\{W \cdot D \cdot B,2 \cdot W \cdot D \cdot B,\dots,(H-1) \cdot W \cdot D \cdot B\right\}$ ,其最小值为 $W \cdot D \cdot B$ ,而其余项的最大值为 $(W-1)(D \cdot B) + (D-1) \cdot B + (B-1) = W \cdot D \cdot B - 1$ 。可见其余项无法“淹没”该项,余下诸项递推可证。
因此,只需确保各位位权为低位所有基数的乘积,则该混合进制可以将有限多维数据单射到一维。
进一步思考,是否依据各维的大小调整权重可以使得映射值的最大值更小?或者说映射的数据更密集?
投射 / Shoot:运动规划(Motion Planning)
Shoot 这步的核心是从纯视觉输入端到端地学到代价地图(cost map),从而实现可解释的运动规划。
文中将规划(planning)定义为:在给定传感器观测 $o$ 的条件下,预测主车在 $K$ 个模板轨迹上的概率分布 $p(\tau|o)$ ,其中模板轨迹集合为
$$\mathcal{T} = \{\tau_i\}_K = \{\{x_j, y_j, t_j\}_T\}_K$$
为了利用代价地图的空间结构,文中将模板轨迹上的分布定义为如下的 Boltzmann 分布形式
$$p(\tau_i|o) = \frac{\exp\left(-\displaystyle\sum_{x_i,y_i \in \tau_i} c_o(x_i, y_i)\right)}{\displaystyle\sum_{\tau \in \mathcal{T}} \exp\left(-\displaystyle\sum_{x_i,y_i \in \tau} c_o(x_i, y_i)\right)}$$
其中 $c_o(x,y)$ 是网络根据观测 $o$ 预测的代价地图在位置 $(x,y)$ 处的值。每条轨迹的代价即为其路径经过的所有位置的代价之和,代价越低的轨迹概率越高。
训练时,给定真值轨迹,先计算其与模板轨迹集合 $\mathcal{T}$ 中各模板的 $L_2$ 距离并取最近邻作为标签,然后用交叉熵损失优化专家轨迹的对数概率。在推理时,通过将不同的模板轨迹投射到代价地图上评分,选择代价最低的轨迹作为输出。
实际应用中,模板轨迹集合通过对大量专家轨迹运行 K-Means 聚类获得,如下图所示

衡准
探微
Q1: 为什么用 Boltzmann 分布而非直接回归轨迹?
A:Boltzmann 分布将规划问题转化为在模板轨迹上的分类问题,其优势在于:
- 学到的 $c_o(x,y)$ 是一个可解释的空间代价函数,可以直观地可视化哪些区域是高代价的(如障碍物、道路边界)
- 相比
NMP中的硬间距(hard-margin)损失,Boltzmann分布形式的交叉熵损失更加稳定 - 轨迹的评分完全由空间代价决定,模型天然具备对新轨迹模板的泛化能力
Q2: 模板轨迹集合 $\mathcal{T}$ 的设计有什么考量?
A:论文中使用 $K=1000$ 个模板,每条轨迹长 $5$ 秒、以 $0.25$ 秒为间隔采样路径点。模板通过对 nuScenes 训练集中所有自车轨迹做 K-Means 聚类获得,因此能覆盖直行、转弯、变道、停车等常见驾驶模式。
思路
任务头 / Task Heads
损失 / Loss
带 Sigmoid 的二元交叉熵损失(Binary Cross Entropy with Logits Loss, BCEWithLogitsLoss)
实践
1. 添加 3D 目标检测任务头
260811
拟采用 CenterPoint 风格的 3D 检测头,即 Heatmap 结合回归目标的位置、尺寸和朝向,具体有:
off_x,off_y:目标中心点在BEV网格上的偏移量z:目标在3D坐标系中的高度log_l,log_w,log_h:目标的3D尺寸,采用对数值防止尺寸差异过大导致梯度爆炸从而让回归更稳定sin_yaw,cos_yaw:目标偏航角的正余弦,采用正余弦解决角度在 $\pm\pi$ 处的跳变
使用 GPT-5.3-Codex 实现一版(22d08ffda1b3571f9ebbe2ad36cf17f7b19665e9),在(全量)训练验证集上训练 $840k$ 步后基本收敛。
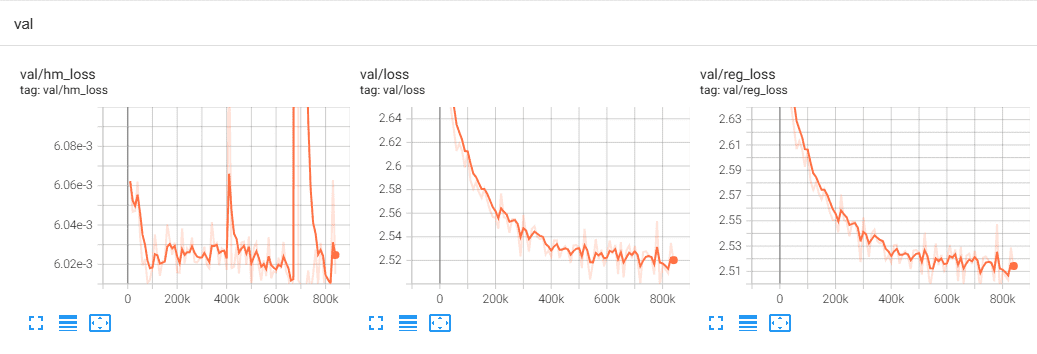
基于该训练过程,选择第 $830k$ 步的权重在迷你数据集上进行评估。
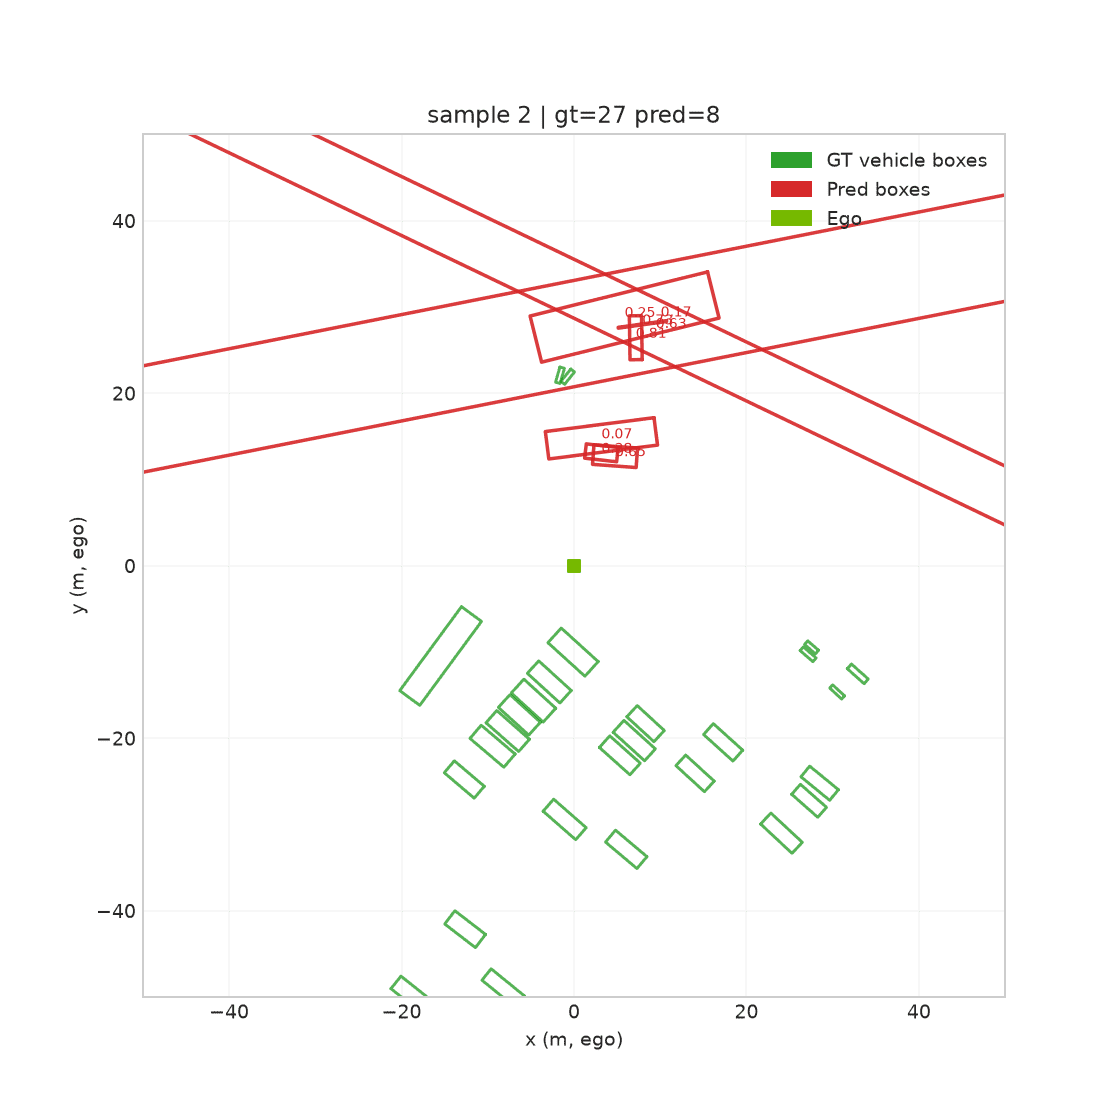
很明显,这个结果很离谱,不说预测和真值一点儿关系都没有吧,至少也是毫不相关。即使将输出阈值提高到 $0.5$ 甚至 $0.8$ 都还是有错误的输出,可见问题不在于输出了低分噪声。
经 AI 分析:
从现象看,比较可能是“目标定义与损失设计不够稳健”,有几方面的因素
- 热力图目标是单像素 $1$ ,其余全 $0$ ,见
data.py:286。这种极稀疏监督用BCE容易学成“中心响应不稳”或校准差。 - 回归分支只在正样本中心点监督,其他位置不约束,见
train.py:223和train.py:225。一旦某个高分中心是错的,该点回归可能给出很怪的尺寸和朝向。 - 解码时直接对尺寸做
exp,没有任何数值约束,见explore.py:289到explore.py:291。这会把回归异常放大成超大框。 - 现在检测头是单类热力图 + 回归,见
models.py:269到models.py:279,没有额外IoU/质量分支来抑制“高分但几何差”的框。
总的来说,当前热力图监督方式 + 回归监督方式 + 解码方式整体设计存在问题。
因此,接下来从两个角度进行优化
- 替换
BCE为其它损失,如CenterNet的Focal Loss,并将中心点改为高斯热力图监督 - 补充如
IoU等质量分支抑制几何差的输出
260820
验证:替换
BCE为Focal Loss
使用 GPT-5.3-Codex 实现一版(0c540a7cc3e06f25c28d2c339fa4e2370b5f0f8e),在(全量)训练验证集上使用三张 H20 训练约 $100k$ 步后发现训练损失在下降,但验证损失反而持续上升。
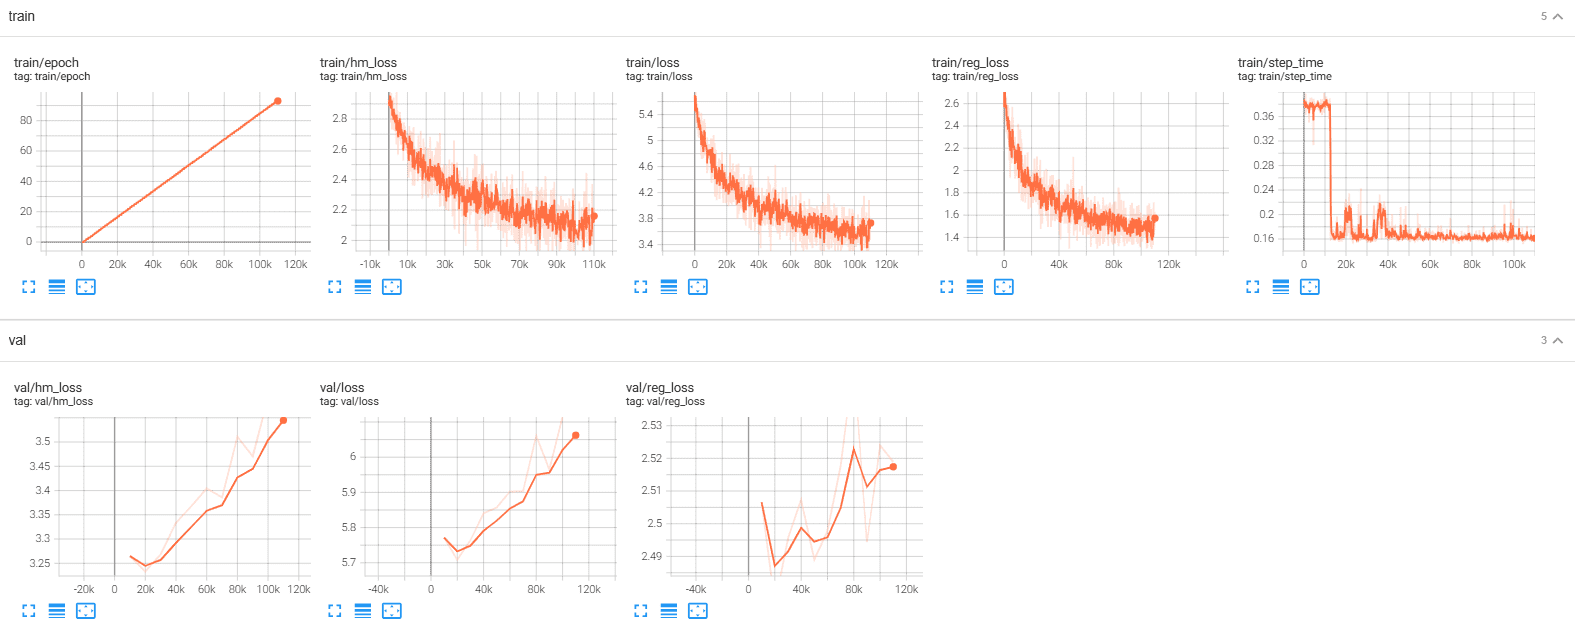
我认为这不是简单的过拟合,因为它在早期训练损失和验证损失就开始背道而驰。但 AI 对此不完全赞同,它认为这虽然不是“训练后期才开始的典型过拟合”,但依然属于很早出现的泛化退化。因为第一次验证是在 $10k$ 步时进行,对于 $bsz=8$ 的 $3$ 卡训练设定下经历了约 $8.5$ epochs ,是有可能已经开始过拟合的。
经 AI 结合代码实现分析:
训练时策略为从 $ncams=5$ 个相机中随机取图,而验证时从全部 $6$ 个相机中取图。这种差异使得验证时特征分布与训练时不同,对于当前简化版的检测头实现来说有可能造成验证损失偏高,需要排除这方面影响
DDP下多卡训练的BatchNorm没有同步DistributedDataParallel(model, ...)当前每个
rank独立维护运行时的mean/variance,而验证仅在rank 0上进行,因此验证仅使用了其上本地累积的BatchNorm统计量,而非三卡。不过其又认为当前 $bsz=8$ 再结合多个相机,这一点可能不是首要问题,只是建议采用更规范的实现model = torch.nn.SyncBatchNorm.convert_sync_batchnorm(model) model = DistributedDataParallel(model, device_ids=[device.index])
因此,建议采用如下排查顺序
- 统一 $ncams=6$ 以控制变量
- 将验证间隔降到每 $2k$ 一次,观察前 $20k$ 的趋势
- 如果仍快速产生差异,再启用
SyncBatchNorm - 额外考察
mAP/NDS等检测指标
260821
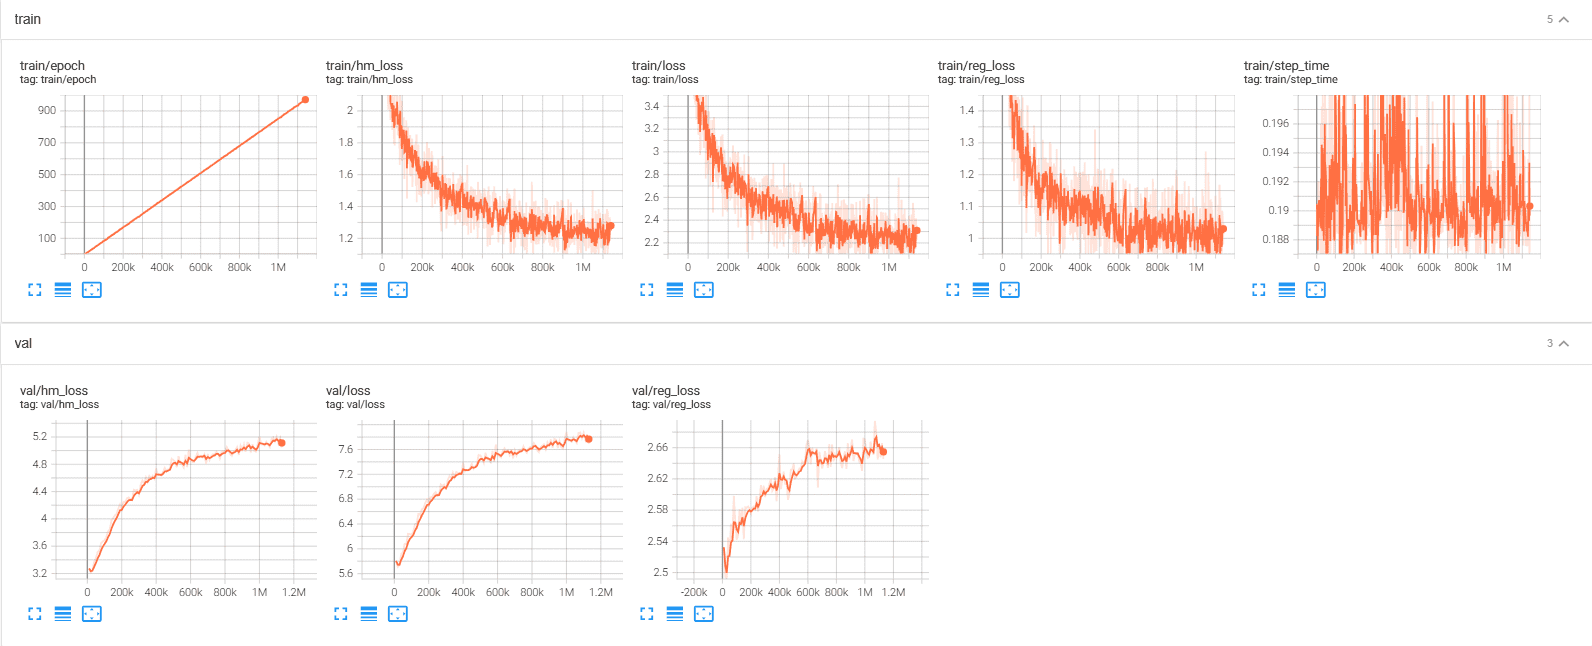
验证:统一 $ncams=6$
使用 GPT-5.6 Sol 实现一版(60ed3974dd382272cb51d6a5a87de9494c31389d),在(全量)训练验证集上训练后结果依旧。
260831
验证:验证间隔降到每 $2k$ 一次,观察前 $20k$ 的趋势
使用 GPT-5.6 Sol 实现一版可配置验证间隔的(703c013c30ea693fe8b163c13e7dfa7d7105af02),并在(全量)训练验证集上重新训练。
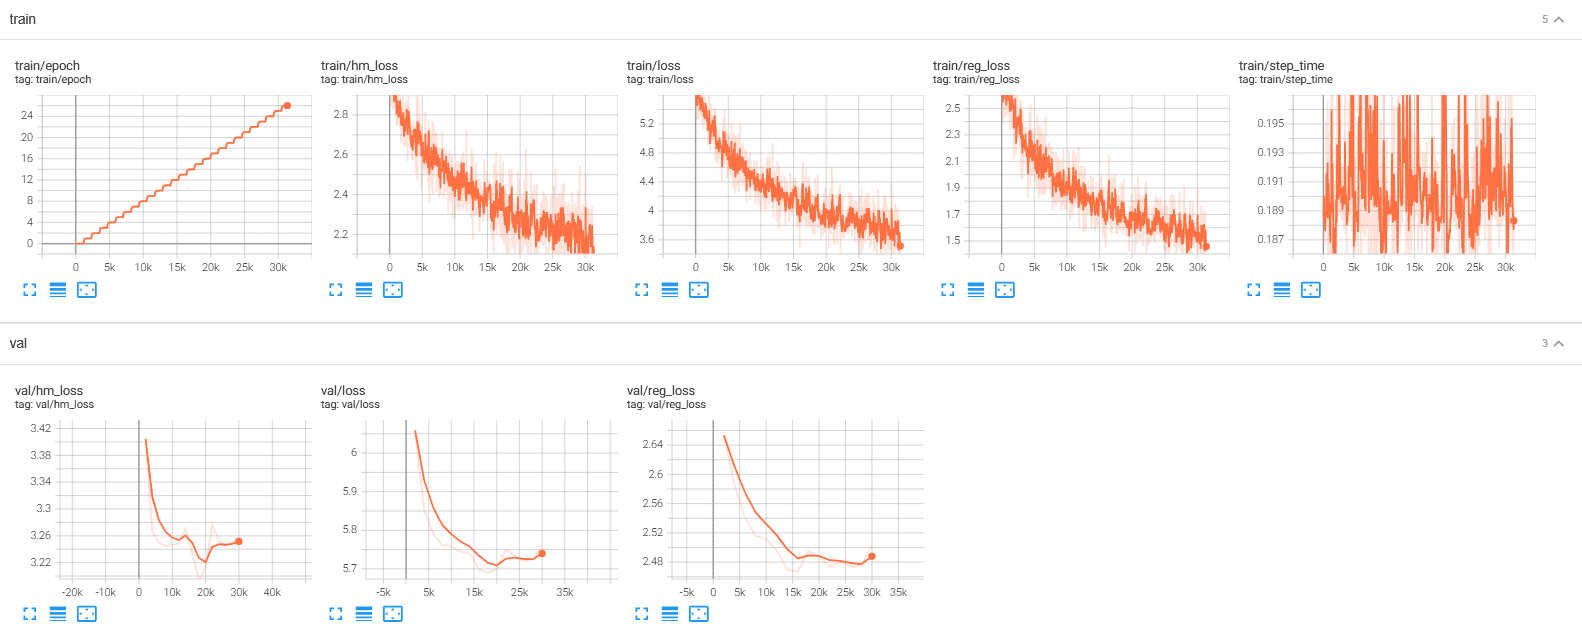
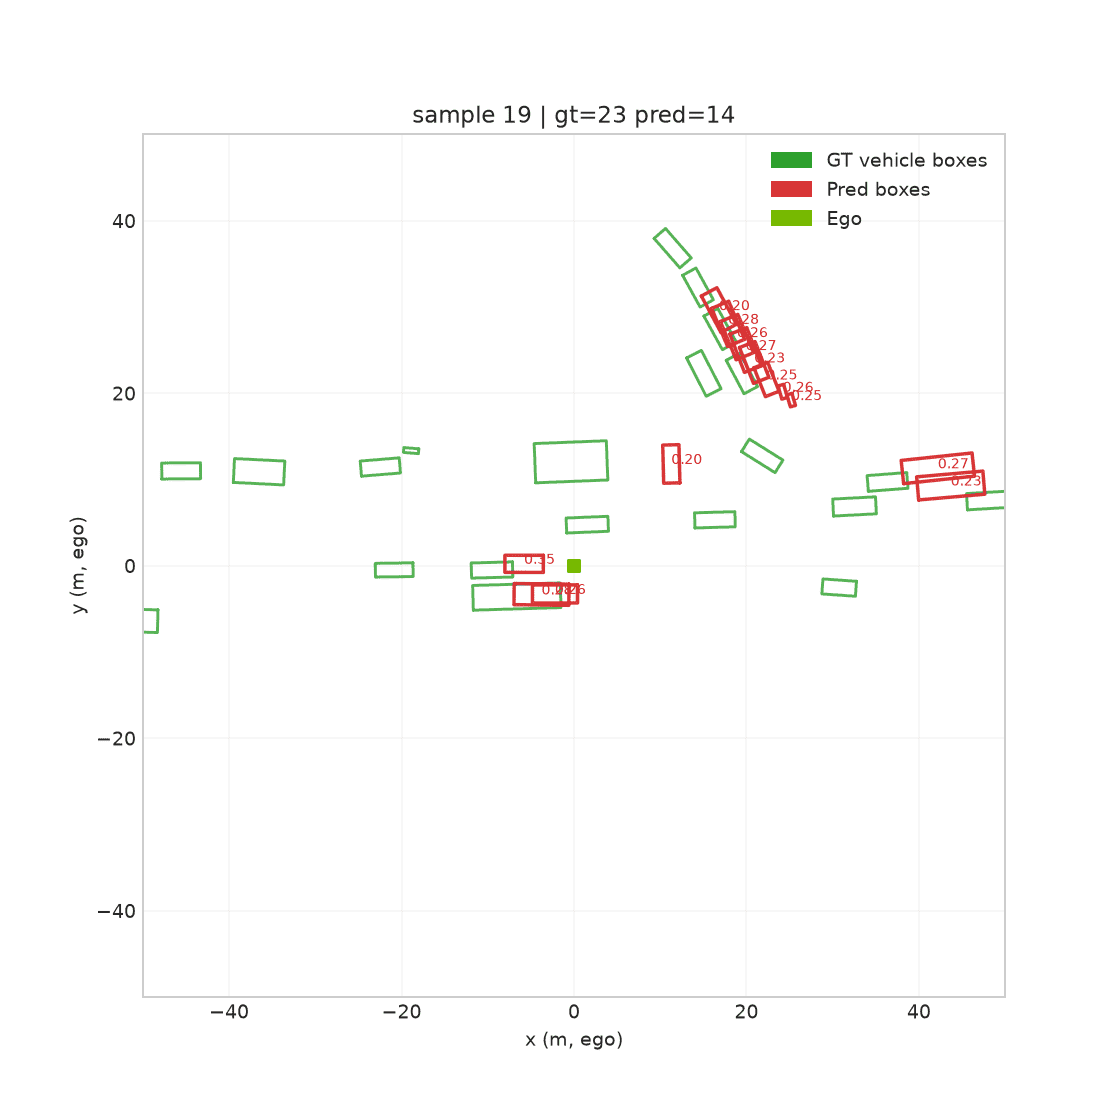
分别观察模型在置信度阈值 $0.2$ 和 $0.05$ 下的预测表现(每组预测 $200$ 个)
- $0.2$ example
- $0.05$ example
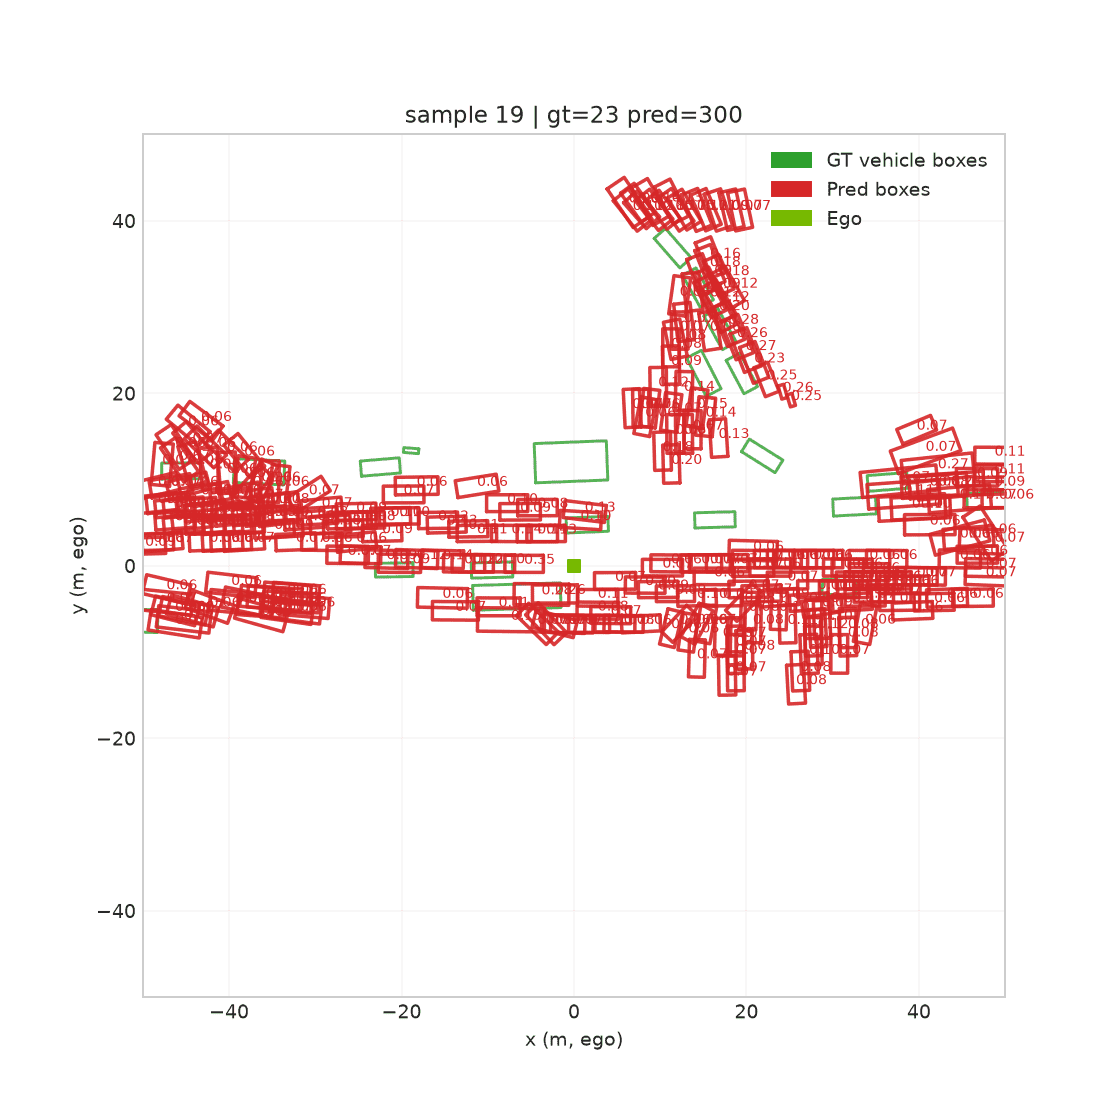
从各组结果观察到如下现象
- 在 $0.2$ 置信度下
- 输出较少,且输出与真值相关性不明显
- 少数几个与真值大差不差的输出在前后帧不能稳定出现,因此不能确定是否偶然
- 在 $0.05$ 置信度下
- 输出大量
Ghost且分布与真值位置分布相关性也不高
- 输出大量
因此,我认为在实现层面有大问题。不应该按照之前的顺序来排查,而应该重新审查代码。
260901
验证:坐标轴
X-Y误用
经 GPT-5.6 Sol 审查发现当前模型输出的空间轴是 [X, Y] ,但检测头按标准图像布局 [Y, X] 解释。修复一版(cfee065dd39792215f1dd6bbbcda8a7aaed2ddeb)后重新训练。
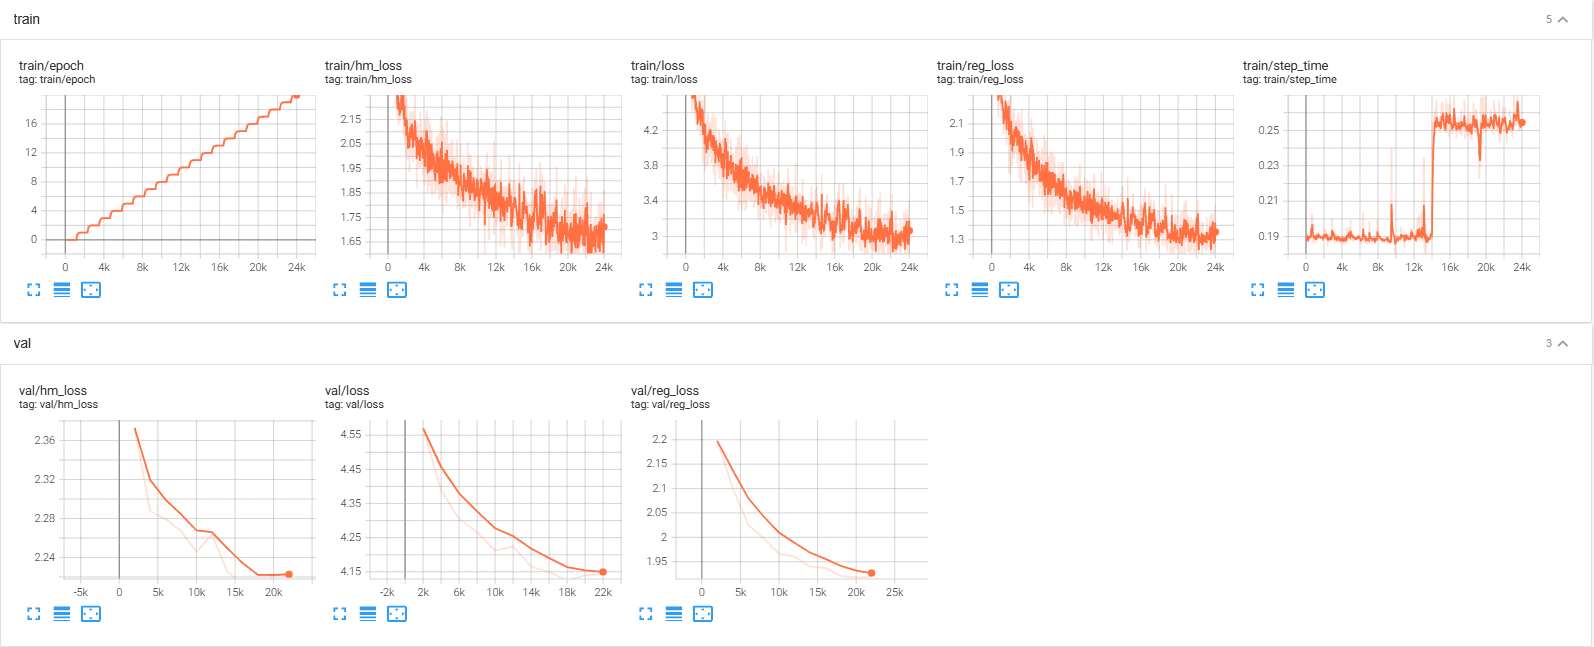
对比 260831 的训练轨迹,验证集上的损失下降过程更平滑合理。因此,先用 $20k$ 处的权重可视化一批样本看看预测效果如何。
从结果看
- 模型整体应该是工作了,可以正常检出目标
- 大拐弯时,模型召回较低
总的来说修复方向是正确的,根因是实现检测头时误解了模型输出的坐标系。
又训练了一会儿,
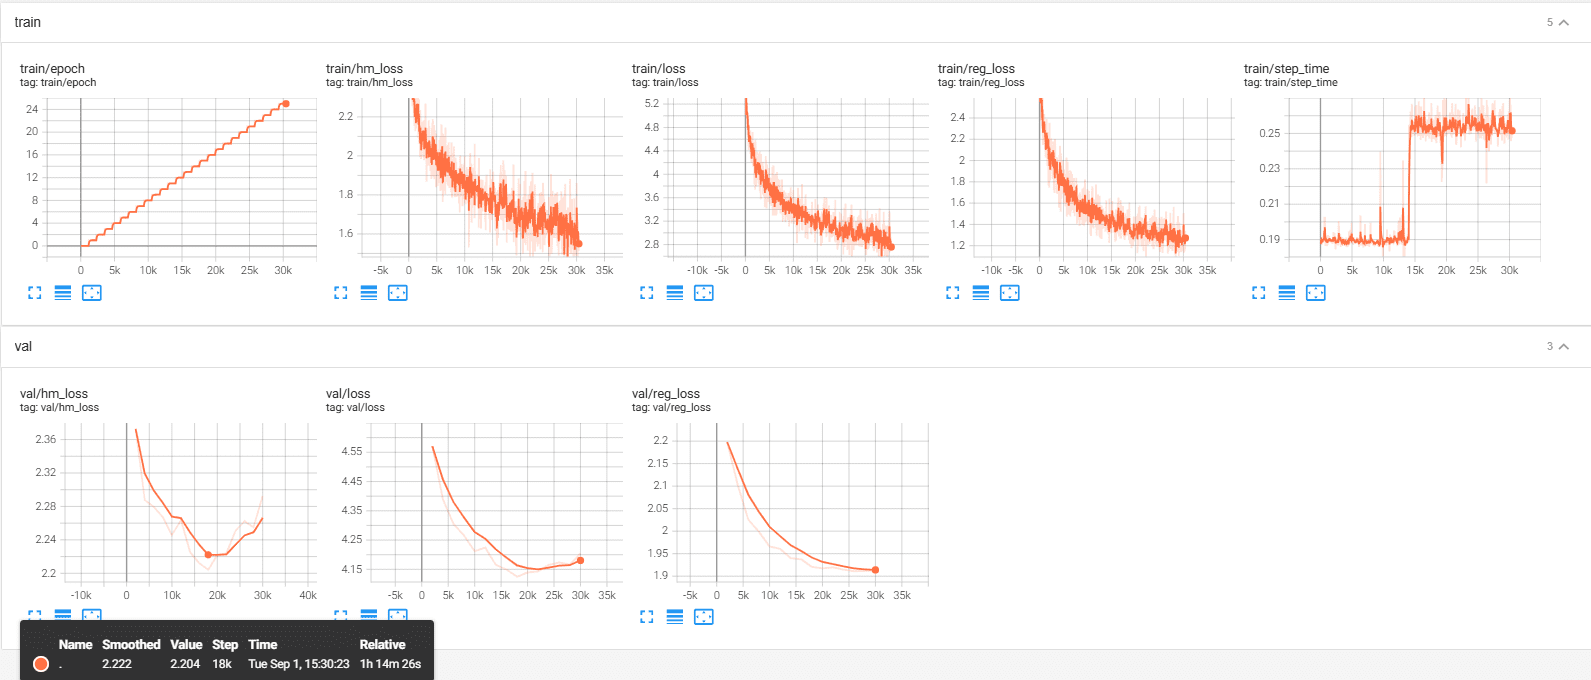
当训练到 $30k$ 步左右时,观察到验证损失在不停上升,遂停止训练。 分析训练过程,可知
- 最低验证损失出现在 $18k$ 步(浅色曲线为实际结果)附近
- 在 $18k$ 步后
heatmap loss持续恶化,而regression loss仍缓慢改善到 $26k$ ,表明这一阶段中心分类头开始过拟合而框回归尚未明显过拟合
在 $22k$ 步权重上进行小批量预测后,经 AI 结合真值对比分析,还有几个问题
TP中位数仅 $0.368$ 而FP中位数更低为 $0.241$ ,表明模型有一定排序能力,但整体校准偏保守recall在 $0 \sim 20m$ , $20 \sim 40m$ , $40 \sim 50m$ 范围上分别为 $86.3\%$ , $39.2\%$ , $11.2\%$ ,表明模型在远距离存在瓶颈- 当前评估工具将超出
BEV训练范围外的真值也算作FN,会夸大漏检
最终给出建议
- 从 $18k \sim 26k$ 中使用官方指标(
mAP/NDS/mATE/mAOE)选择最优模型 - 在后段使用更低的学习率
- 加入
cosine decay或ReduceLROnPlateau
260903
验证:功能拓展
使用 GPT-5.6 Sol 实现一版(00a09a9841443f2baf74164adca9fa63fb5d1766)以拓展功能
- 支持训练恢复
- 支持全部
nuScenes类别 - 预测结果可视化效果提升
重新训练如下
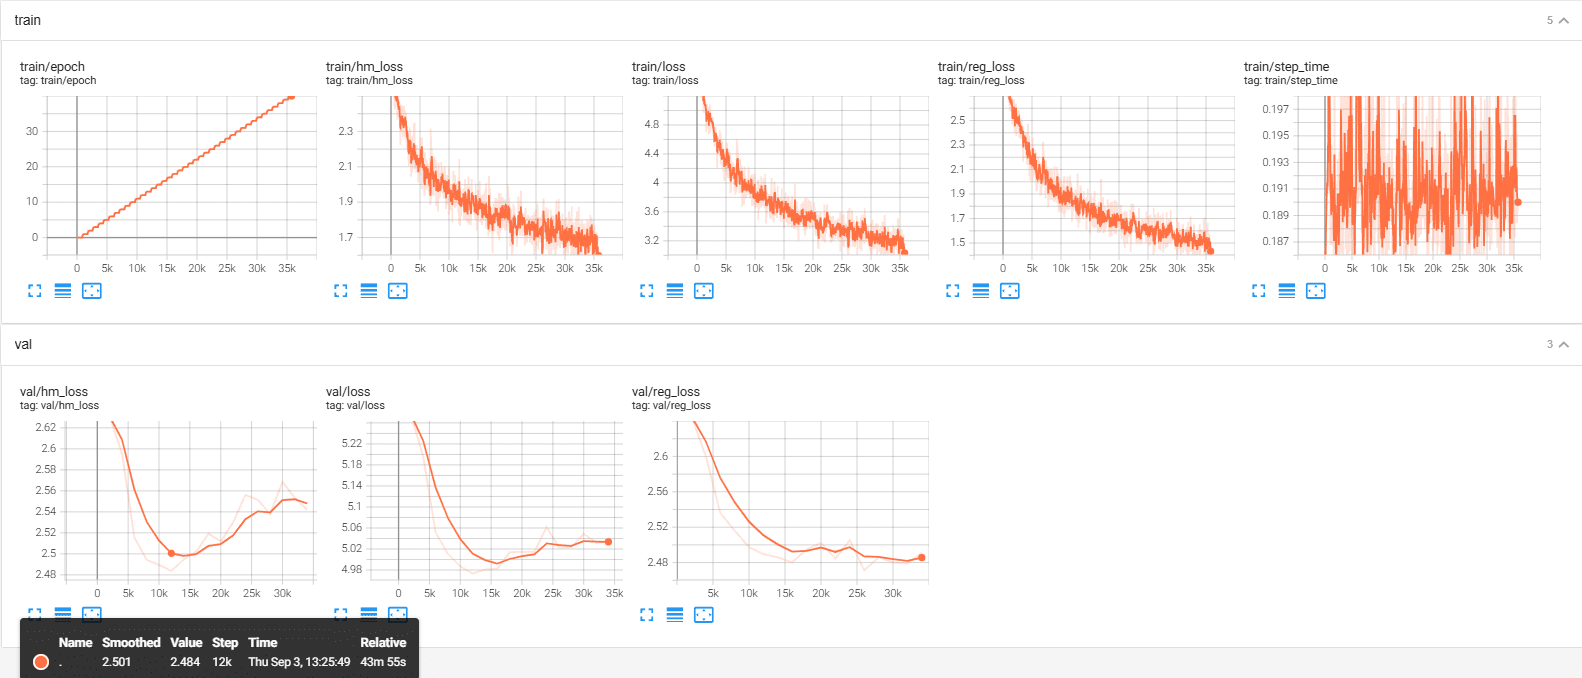
可见,在 $12k$ 步后,
- 训练
heatmap loss持续下降,但验证heatmap loss确总体上升,有轻度过拟合 regression loss还在继续改善,但可能被heatmap loss的劣化掩盖
在 $12k$ 步处对模型的预测效果进行小批量可视化
docker compose exec -e CUDA_VISIBLE_DEVICES=2 lss \
  python main.py viz_det_preds trainval \
    --modelf=/srv/share/yirami/cache/runs_det/model_det12000.pt \
    --dataroot=/srv/share/nuscenes \
    --out_dir=/srv/share/yirami/cache/viz_det_12000 \
    --gpuid=0 \
    --score_thresh=0.2 \
    --topk=500 \
    --match_distance=2.0 \
    --max_samples=200 \
    --ncams=6 \
    --bsz=1 \
    --nworkers=4 \
    --video_format=mp4 \
    --video_fps=4
从新的预测可视化结果来看,网络工作了,但是性能不好,表现在
- 误检、漏检都较多
- 检出的目标置信度也不高
再使用 nuScenes 的官方指标定量评估一下
docker compose exec -e CUDA_VISIBLE_DEVICES=2 lss \
  python main.py eval_det_nuscenes trainval \
    --modelf=/srv/share/yirami/cache/runs_det/model_det12000.pt \
    --dataroot=/srv/share/nuscenes \
    --out_dir=/srv/share/yirami/cache/eval_det_12000 \
    --gpuid=0 \
    --score_thresh=0.01 \
    --topk=500 \
    --ncams=6 \
    --bsz=2 \
    --nworkers=8 \
    --render_curves=True
执行上述命令,将生成如下目录结构
eval_det_12000/
├── results_nusc.json
├── metrics_summary.json
├── metrics_details.json
└── plots/
其中 results_nusc.json 是模型对整个验证集的原始预测,采用 nuScenes 官方提交格式,包含
- sample token
- 全局坐标位置
- 尺寸
- 四元数朝向
- 速度
- 类别
- 置信度
- 属性
该文件将作为 evaluator 的输入,而 metrics_summary.json 就是官方指标的汇总文件,其结果如下
| 指标 | 数值 | 含义 |
|---|---|---|
| mAP(mean Average Precision) | 0.1127 | 10 类、4 个中心距离阈值的平均 AP,越高越好 |
| NDS(nuScenes Detection Score) | 0.1932 | 综合 AP 和各类 TP error 的总分,越高越好 |
| mATE(mean Average Translation Error) | 0.9877 m | 中心位置误差,越低越好 |
| mASE(mean Average Scale Error) | 0.3338 | 尺寸误差,越低越好 |
| mAOE(mean Average Orientation Error) | 0.9425 rad | 朝向误差,越低越好 |
| mAVE(mean Average Velocity Error) | 1.1158 m/s | 速度误差,越低越好 |
| mAAE(mean Average Attribute Error) | 0.3672 | 属性误差,越低越好 |
其中,因当前模型不预测速度,属性也是默认填写,因此:
mAVE不应作为核心依据mAAE参考意义有限NDS会被这两项拖低- 最值得看的是
mAP/mATE/mASE/mAOE
每类平均 AP 如下:
| 类别 | AP |
|---|---|
| traffic_cone | 0.2885 |
| car | 0.2709 |
| barrier | 0.2454 |
| pedestrian | 0.1412 |
| motorcycle | 0.0610 |
| bus | 0.0459 |
| bicycle | 0.0342 |
| truck | 0.0302 |
| trailer | 0.0061 |
| construction_vehicle | 0.0037 |
可以观察到:
- car、锥桶和护栏已有基本检测能力
- pedestrian 有一定效果
- 大型和长尾车辆类别表现很弱
- trailer、construction vehicle 基本尚未学会
上述主要官方指标可以使用如下命令(注意调整报告路径)快速查看
python - <<'PY'
import json

path = "/srv/share/yirami/cache/eval_det_12000/metrics_summary.json"

with open(path) as file:
    metrics = json.load(file)

print("mAP :", metrics["mean_ap"])
print("NDS :", metrics["nd_score"])

for name, value in metrics["tp_errors"].items():
    print(f"{name:12s}: {value:.4f}")

print("\nPer-class AP")
for name, value in metrics["mean_dist_aps"].items():
    print(f"{name:22s}: {value:.4f}")
PY
顶层最后一个文件 metrics_details.json 就是完整 PR 曲线的底层数据,它按 类别:中心距离阈值 的形式输出,主要用于:
- 自己绘制 PR 曲线
- 分析 recall、precision、confidence
- 比较不同距离阈值
- 调试官方 evaluator
通常无需直接使用该文件。顶层还有一个 plots 目录,其中
plots/summary.pdf:图形汇总文件(推荐最先打开)- 主要汇总了
PR和TPerror 结果,适合快速浏览整体情况
- 主要汇总了
plots/{class}_pr.pdf:每个类别的Precision-Recall曲线,用于观察:- 最大召回率
precision随recall的下降- 不同中心距离阈值下的表现
- 某个类别是“检测不到”还是“误报太多”
plots/{class}_tp.pdf:每个类别的TPerror 曲线,显示不同recall下的:- translation error
- scale error
- orientation error
- velocity error
- attribute error
plots/dist_pr_{threshold}.pdf:固定中心距离阈值下比较所有类别,其中特别值得比较:0.5m:严格定位能力2.0m:中等容忍度4.0m:目标是否至少被大致找到
本次 car 的结果很能说明问题:
距离阈值 Car AP 0.5m 0.046 1.0m 0.214 2.0m 0.362 4.0m 0.461 从
0.5m到4m提升很大,说明模型经常能找到汽车,但中心定位精度仍然不足。这和mATE=0.988m一致。
在日常模型调优中,建议可按如下顺序查看报告:
metrics_summary.json中的 mAP/NDSmean_dist_aps判断弱类别tp_errors判断位置、尺寸和朝向问题plots/summary.pdf- 弱类别对应的
{class}_pr.pdf dist_pr_0.5.pdf和dist_pr_2.0.pdf
虽然在 $12k$ 步处的评估暴露出不少问题,如少数类别检测能力弱等,但目前还是先回到最初的方向,即系统评估不同 checkpoint 上的官方指标,更准确的判断模型当前的训练状态。
经评估,各指标统计如下
| step | mAP | traffic cone AP | car AP | barrier AP | pedestrian AP | motorcycle AP | bus AP | bicycle AP | truck AP | trailer AP | construction vehicle AP | NDS | mATE | mASE | mAOE | mAVE | mAAE |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| $12,000$ | $0.1127$ | $0.2885$ | $0.2709$ | $0.2454$ | $0.1412$ | $0.0610$ | $0.0459$ | $0.0342$ | $0.0302$ | $0.0061$ | $0.0037$ | $0.1932$ | $0.9877$ | $0.3338$ | $0.9425$ | $1.1158$ | $0.3672$ |
| $14,000$ | $0.1175$ | $0.3003$ | $0.2758$ | $0.2569$ | $0.1324$ | $0.0693$ | $0.0367$ | $0.0628$ | $0.0357$ | $0.0039$ | $0.0017$ | $0.2032$ | $0.9688$ | $0.3231$ | $0.8949$ | $1.1578$ | $0.3694$ |
| $16,000$ | $0.1202$ | $0.3044$ | $0.2807$ | $0.2590$ | $0.1386$ | $0.0742$ | $0.0465$ | $0.0487$ | $0.0394$ | $0.0059$ | $0.0043$ | $0.2106$ | $0.9651$ | $0.3194$ | $0.8411$ | $1.1053$ | $0.3694$ |
| $18,000$ | $0.1191$ | $0.2950$ | $0.2858$ | $0.2579$ | $0.1320$ | $0.0773$ | $0.0532$ | $0.0393$ | $0.0398$ | $0.0067$ | $0.0043$ | $0.2072$ | $0.9594$ | $0.3215$ | $0.8664$ | $1.1649$ | $0.3762$ |
| $20,000$ | $0.1203$ | $0.3025$ | $0.2875$ | $0.2694$ | $0.1334$ | $0.0691$ | $0.0505$ | $0.0351$ | $0.0388$ | $0.0108$ | $0.0062$ | $0.2089$ | $0.9747$ | $0.3180$ | $0.8572$ | $1.0961$ | $0.3630$ |
| $22,000$ | $0.1235$ | $0.3092$ | $0.2909$ | $0.2716$ | $0.1354$ | $0.0797$ | $0.0525$ | $0.0387$ | $0.0406$ | $0.0092$ | $0.0075$ | $0.2094$ | $0.9715$ | $0.3281$ | $0.8540$ | $1.1586$ | $0.3701$ |
| $24,000$ | $0.1248$ | $0.3166$ | $0.2970$ | $0.2655$ | $0.1388$ | $0.0754$ | $0.0453$ | $0.0499$ | $0.0455$ | $0.0056$ | $0.0081$ | $0.2122$ | $0.9480$ | $0.3286$ | $0.8605$ | $1.1042$ | $0.3646$ |
| $26,000$ | $0.1308$ | $0.3251$ | $0.2987$ | $0.2818$ | $0.1418$ | $0.0854$ | $0.0559$ | $0.0538$ | $0.0495$ | $0.0098$ | $0.0059$ | $0.2187$ | $0.9489$ | $0.3148$ | $0.8279$ | $1.1273$ | $0.3755$ |
各指标的趋势变化如下图

虽然从趋势看指标缓慢向好,但整体指标偏低,尤其是
- 从 $12k$ 到 $26k$ 这 $14k$ 步的训练仅仅将
mAP从原来的 $0.1127$ 提升到 $0.1308$ - 中心误差(mATE)长期徘徊于 $0.95m$ 附近
- 还有之前观察到的不少类别几乎不可用的问题
模型的训练不像是典型的“前期快速掌握任务,后期逐渐收敛”状态,因此还是高度怀疑代码中有大问题。
经 GPT-5.6 Sol 再次审查后发现可能存在如下架构问题:
检测头中未使用
BEV encoderclass LiftSplatShootDet(LiftSplatShoot): def __init__(self, grid_conf, data_aug_conf, num_classes=len(DETECTION_NAMES), regC=8): super(LiftSplatShootDet, self).__init__(grid_conf, data_aug_conf, outC=1) self.bevencode.requires_grad_(False) self.det_head = DetHead(inC=self.camC * int(self.nx[2].item()), num_classes=num_classes, regC=regC) def forward(self, x, rots, trans, intrins, post_rots, post_trans): x = self.get_voxels(x, rots, trans, intrins, post_rots, post_trans) x = x.transpose(-1, -2).contiguous() return self.det_head(x)可以看到其中的
self.bevencode没有被调用,且不可学习解码部分存在两个问题
使用全局
Top-Kdef _decode_det_predictions(hm_logits, reg_pred, dx, bx, score_thresh=0.2, topk=500): ... for bi in range(B): scores = hm[bi].reshape(-1) k = min(topk, scores.numel()) top_scores, top_inds = torch.topk(scores, k) ...当前在所有类别和所有位置间取 $500$ 个峰值,数量较多的类别会挤压少数类别
没有正式
NMS当前仅有 $3 \times 3$ 的 heatmap 局部极大值抑制,没有
class-wise circle NMS或旋转框非极大值抑制(Rotated NMS),会导致同一目标附近的重复预测可能作为多个FP进入官方评测,而官方评测限制每帧 $500$ 个框,重复预测同样可能挤压少数类别
综合来看,接下来应该
- 先在当前训练权重上修正解码问题,可以独立解码问题带来的评估收益
- 再修复
BEV backbone中特征未使用的架构问题,并重新训练
261008
验证:修复
BEV backbone中未使用编码器的架构问题
使用 GPT-6.1 Sol 修复一版(4d0ef5e7de8609b19d4cf0eeccbc48dec08d2458)接入可训练的多尺度 BEV 编码器后重新训练。

选择第 $56k$ 步进行评估(同样使用 $0.01$ 作为置信度阈值),各指标如下:
| step | mAP | traffic cone AP | car AP | barrier AP | pedestrian AP | motorcycle AP | bus AP | bicycle AP | truck AP | trailer AP | construction vehicle AP | NDS | mATE | mASE | mAOE | mAVE | mAAE |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| $12,000$ (改之前) | $0.1127$ | $0.2885$ | $0.2709$ | $0.2454$ | $0.1412$ | $0.0610$ | $0.0459$ | $0.0342$ | $0.0302$ | $0.0061$ | $0.0037$ | $0.1932$ | $0.9877$ | $0.3338$ | $0.9425$ | $1.1158$ | $0.3672$ |
| $56,000$ (改之后) | $0.1206$ | $0.2814$ | $0.3336$ | $0.2883$ | $0.1111$ | $0.0515$ | $0.0407$ | $0.0339$ | $0.0416$ | $0.0146$ | $0.0089$ | $0.2098$ | $0.8931$ | $0.3348$ | $0.8976$ | $1.2358$ | $0.3793$ |
相比改动之前在 $12k$ 步处的评估结果来看,收益不大。继续分析可能的原因,可能有如下几点
- 相机特征与标签没有统一参考帧
在NuscData的实现中,图像只使用calibrated_sensor,投影得到的是各相机拍摄时刻的ego坐标;标签却使用LiDAR时刻的ego坐标。缺少这一转换过程。这种几何错误,会造成特征与监督错位,以及不同相机之间的融合错位相机坐标 → 相机时刻 ego → global → LiDAR 时刻 ego - 监督目标中包含官方忽略的零点数标注
没有排除num_lidar_pts + num_radar_pts == 0的目标。模型被训练去检测它们,但官方评估删除对应GT,相关预测仍可能成为FP - 解码缺少框级几何去重
当前只有 3×3 热图抑制。默认网格下,同一目标相隔约 $1m$ 的两个峰可以同时输出,没有后续rotated NMS或circle NMS,这一点对大车的影响较大 - 体素边界与翻转存在确定错误
voxel_pooling中使用.long()对负数向零截断,边界外的点可能进入第一个体素。默认 $Z$ 步长为 $20m$ ,$z=-15$ 也会错误进入有效层img_transform中使用width-x而实际应为width-1-x
261009
验证:统一参考系并排除零点数的标注
在上一轮验证的分析结论中,我认为前两条是主要矛盾的可能性较大,因此用 GPT-6.1 Sol 实现一版(8fff969083ec895070a0d2c785e1de2bf25d96f5)统一参考帧并排除零点数标注,然后重新训练。

从训练过程中的验证损失变化来看,下降过程似乎没有那么毛躁了,但整体趋势仍未改变。选择在验证集上总损失低点的 $44k$ 步和训练尾声的 $120k$ 步分别评估(同样使用 $0.01$ 作为置信度阈值),各指标如下:
| step | mAP | traffic cone AP | car AP | barrier AP | pedestrian AP | motorcycle AP | bus AP | bicycle AP | truck AP | trailer AP | construction vehicle AP | NDS | mATE | mASE | mAOE | mAVE | mAAE |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| $56,000$ (改之前) | $0.1206$ | $0.2814$ | $0.3336$ | $0.2883$ | $0.1111$ | $0.0515$ | $0.0407$ | $0.0339$ | $0.0416$ | $0.0146$ | $0.0089$ | $0.2098$ | $0.8931$ | $0.3348$ | $0.8976$ | $1.2358$ | $0.3793$ |
| $44,000$ | $0.1303$ | $0.2954$ | $0.3407$ | $0.3083$ | $0.1172$ | $0.0568$ | $0.0532$ | $0.0388$ | $0.0623$ | $0.0239$ | $0.0063$ | $0.22$ | $0.8841$ | $0.3351$ | $0.8596$ | $1.1959$ | $0.3724$ |
| $120,000$ | $0.1464$ | $0.2997$ | $0.3701$ | $0.3272$ | $0.1209$ | $0.0734$ | $0.0949$ | $0.0476$ | $0.0771$ | $0.0489$ | $0.0038$ | $0.2446$ | $0.8441$ | $0.3190$ | $0.7618$ | $1.2056$ | $0.3614$ |
对比指标,可以看出:
- $44k$ 步相比改之前 $56k$ 步的指标,表现整体稍好(除了
construction vehicle和mASE) - $44k$ 步到 $120k$ 步的训练虽然显示热力图损失的泛化差距扩大,但并未导致整体性能的退化(除了
construction和mAVE) - 回归损失虽然进入平台期,但实际解码出的目标框仍在改善
从评估报告还能看出,随着模型的训练,AP 的提升更多的发生在高距离阈值下,表明当前模型在精确定位上仍然不足,这从预测热力图输出也能看出

近几个版本的优化似乎都没有发生显著的提升,因此接下来我考虑在 $44k$ 和 $120k$ 这两个 checkpoint 上调整学习率进行二次训练,看看
- 当前实现的极限效果能到什么程度
- 对比早期的损失低点和后期热力图损失略微过拟合这两个状态下的二次训练有没有显著差异
261010
验证:在两个阶段分别验证更低学习率的效果
分别加载 $44k$ 和 $120k$ 这两处的纯权重(重置 Adam 优化器)并降低学习率到 $1E-4$ 后继续训练,训练过程分别如下
- $44k$

- $120k$

两处验证的状态表明:训练和验证的泛化间隙持续增大,模型处于过拟合阶段,放弃在该分支继续深入。
261012
验证:采用独立的框回归头
相比完整的 CenterPoint 实现,当前属于简化版本。当前实现中所有类别共享一个 $8$ 通道回归输出,没有按中心偏移、尺寸、高度、朝向拆分独立回归分支,使用 GPT-6.1 Sol 完善一版(92e4297cd0735b614cb912e899973d8cbf3120d4)将偏移、高度、尺寸、朝向拆分出四个独立卷积回归分支,并共享 BEV 特征与检测头前置特征,然后重新训练。

从训练过程可以看出
- 约 $2k \sim 14k$ 为正常学习阶段
- 约 $14k \sim 28k$ 为平台期,三项验证损失皆在此阶段出现最低点
- 约 $30k \sim$ 为过拟合阶段,此时训练越拟合,验证集表现越差
从这三个阶段中分别挑选几个点( $14k, 28k, 44k, 100k, 194k$ )进行评估
| step | mAP | traffic cone AP | car AP | barrier AP | pedestrian AP | motorcycle AP | bus AP | bicycle AP | truck AP | trailer AP | construction vehicle AP | NDS | mATE | mASE | mAOE | mAVE | mAAE |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 14,000 | 0.1448 | 0.3041 | 0.3552 | 0.3116 | 0.1133 | 0.0670 | 0.1263 | 0.0552 | 0.0734 | 0.0384 | 0.0029 | 0.2330 | 0.8798 | 0.3270 | 0.8100 | 1.1996 | 0.3773 |
| 28,000 | 0.1507 | 0.3096 | 0.3739 | 0.3173 | 0.1255 | 0.0799 | 0.1223 | 0.0512 | 0.0717 | 0.0497 | 0.0054 | 0.2463 | 0.8523 | 0.3191 | 0.7462 | 1.1694 | 0.3726 |
| 44,000 | 0.1571 | 0.3062 | 0.3865 | 0.3549 | 0.1232 | 0.0807 | 0.1361 | 0.0409 | 0.0791 | 0.0539 | 0.0092 | 0.2481 | 0.8435 | 0.3192 | 0.7761 | 1.1678 | 0.3657 |
| 100,000 | 0.1526 | 0.2865 | 0.3913 | 0.3760 | 0.1071 | 0.0683 | 0.1195 | 0.0367 | 0.0660 | 0.0648 | 0.0095 | 0.2560 | 0.8288 | 0.3121 | 0.7145 | 1.1710 | 0.3478 |
| 194,000 | 0.1448 | 0.2812 | 0.3716 | 0.3899 | 0.1061 | 0.0573 | 0.0958 | 0.0164 | 0.0659 | 0.0547 | 0.0091 | 0.2503 | 0.8536 | 0.3118 | 0.7047 | 1.1407 | 0.3510 |
从 mAP 评分来看,在 $44k$ 步处为最佳状态,后续到 $100k$ 之间虽然 NDS 仍有提升,但 mAP 已有退化。因此选择 $44k$ 处为起点,尝试降低学习率到 $1E-4$ 并继续训练。因当前工程实现不支持从 .ckpt 恢复并覆盖学习率(仅支持从 .pt 恢复,此时 Adam 状态同样丢失),使用 GPT-6.1 Sol 补充一版(3c8c2ebed00d00c738cb9ba01ea04f80d4c958a0)添加相关支持。
考虑到 $44k$ 处约位于 $epoch\ 50$ ,因此仅尝试续训到 $epoch\ 70$ 即可
./tools/train_lss.sh 0,1,2,3 \
  --resume=/srv/share/yirami/cache/runs_lss_det_independent/checkpoint_det44000.ckpt \
  --lr=1e-4 \
  --nepochs=70 \
  --logdir=/srv/share/yirami/cache/runs_lss_det_independent_lr1e4
其训练过程如下

同样,选择多个点来评估
python tools/export_metrics_curve.py eval_lss_det_independent_lr1e4/eval_det*/ -o metrics_independent_lr1e4.csv并将结果汇总如下
| step | mAP | traffic cone AP | car AP | barrier AP | pedestrian AP | motorcycle AP | bus AP | bicycle AP | truck AP | trailer AP | construction vehicle AP | NDS | mATE | mASE | mAOE | mAVE | mAAE |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 46,000 | 0.1643 | 0.3118 | 0.3998 | 0.3734 | 0.1248 | 0.0958 | 0.1358 | 0.0484 | 0.0809 | 0.0607 | 0.0115 | 0.2577 | 0.8325 | 0.3124 | 0.7412 | 1.1696 | 0.3588 |
| 50,000 | 0.1651 | 0.3097 | 0.4015 | 0.3798 | 0.1223 | 0.0970 | 0.1405 | 0.0486 | 0.0824 | 0.0573 | 0.0120 | 0.2597 | 0.8229 | 0.3119 | 0.7337 | 1.1627 | 0.3600 |
| 52,000 | 0.1651 | 0.3075 | 0.4009 | 0.3822 | 0.1220 | 0.1003 | 0.1474 | 0.0453 | 0.0800 | 0.0528 | 0.0126 | 0.2606 | 0.8200 | 0.3118 | 0.7250 | 1.1732 | 0.3628 |
| 54,000 | 0.1640 | 0.3125 | 0.4013 | 0.3802 | 0.1214 | 0.0912 | 0.1357 | 0.0433 | 0.0800 | 0.0608 | 0.0138 | 0.2609 | 0.8208 | 0.3128 | 0.7219 | 1.1842 | 0.3554 |
| 60,000 | 0.1623 | 0.3073 | 0.4006 | 0.3793 | 0.1200 | 0.0923 | 0.1304 | 0.0457 | 0.0778 | 0.0565 | 0.0132 | 0.2587 | 0.8155 | 0.3128 | 0.7395 | 1.1782 | 0.3563 |
从评估来看,模型最佳状态在 $52k$ 步处。结合训练过程中验证损失的变化还可以发现,在这一降低学习率的训练过程中,验证损失在上升但评估指标反而还在下降,这是因为
heatmap loss更多的关注目标检测概率的拟合,而AP更多的关注预测排序和匹配,因此少量的高置信度误检可能会增大基于Gaussian Focal Loss计算的heatmap loss,而目标的预测排序及召回还是可能被改善regression loss和mAP/NDS指标同样具备不同的评估目标regression loss是在GT中心所在的BEV格子提取预测回归参数,与GT参数比较,衡量给定正确格子时,中心偏移、尺寸、高度和朝向等参数的预测能力mAP/NDS指标则是由模型先筛选heatmap的局部峰值,再通过Top-K和置信度阈值选择候选位置,读取这些位置的回归参数并解码为检测框,最后与GT匹配打分。mAP衡量各类别在不同中心距离阈值下的检测表现,反映目标发现、分类、置信度排序和定位能力,包含漏检与误检的影响NDS则在mAP基础上,进一步结合匹配目标的定位、尺寸、朝向、速度和属性误差
261014
验证:采用类别分组
接下来进一步验证类别分组对模型的影响,使用 GPT-6.1 Sol 实现一版(83e4367916254bce4591254a0f6de266ac98ce77),共分六组:
- car
- truck + construction_vehicle
- bus + trailer
- barrier
- motorcycle + bicycle
- pedestrian + traffic_cone
其中,各组拥有独立的 heatmap 输出和回归分支,组内类别共享回归参数。
在训练和评估时传入参数 --grouped_heads=True 以启用分组,并重新开始训练

从训练过程可以看出,随着训练 loss 下降,验证总 loss 在经历早期 $\sim 12k$ 的下降到达最低后逐渐回升,主要还是来自 heatmap loss 。
初步选择几个点( $12k, 28k, 44k, 60k, 100k, 114k$ )进行评估
| step | mAP | traffic cone AP | car AP | barrier AP | pedestrian AP | motorcycle AP | bus AP | bicycle AP | truck AP | trailer AP | construction vehicle AP | NDS | mATE | mASE | mAOE | mAVE | mAAE |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 12,000 | 0.1337 | 0.3091 | 0.3599 | 0.2666 | 0.1208 | 0.0695 | 0.0739 | 0.0405 | 0.0617 | 0.0328 | 0.0020 | 0.2285 | 0.8971 | 0.3043 | 0.8055 | 1.2220 | 0.3766 |
| 28,000 | 0.1528 | 0.3150 | 0.3906 | 0.3307 | 0.1257 | 0.0801 | 0.0953 | 0.0506 | 0.0859 | 0.0505 | 0.0040 | 0.2518 | 0.8492 | 0.3076 | 0.7258 | 1.1873 | 0.3631 |
| 44,000 | 0.1581 | 0.3048 | 0.3969 | 0.3512 | 0.1223 | 0.0759 | 0.1212 | 0.0460 | 0.0921 | 0.0585 | 0.0126 | 0.2591 | 0.8438 | 0.3018 | 0.6909 | 1.1287 | 0.3631 |
| 60,000 | 0.1568 | 0.2928 | 0.3895 | 0.3793 | 0.1168 | 0.0735 | 0.1321 | 0.0338 | 0.0896 | 0.0524 | 0.0084 | 0.2567 | 0.8536 | 0.3035 | 0.6971 | 1.1217 | 0.3625 |
| 100,000 | 0.1590 | 0.3012 | 0.3995 | 0.3944 | 0.1096 | 0.0666 | 0.1137 | 0.0449 | 0.0841 | 0.0632 | 0.0126 | 0.2601 | 0.8302 | 0.2983 | 0.7148 | 1.1686 | 0.3506 |
| 114,000 | 0.1563 | 0.2861 | 0.3957 | 0.3869 | 0.1158 | 0.0658 | 0.1216 | 0.0416 | 0.0756 | 0.0657 | 0.0077 | 0.2581 | 0.8300 | 0.2980 | 0.7126 | 1.1217 | 0.3596 |
从 mAP 评分来看,在 $100k$ 步处为最佳状态,但其相比 $44k$ 处提升不明显,而 $12k$ 处虽是总 loss 最低点,但其检测评分也最低。以 $44k$ 为切入点,相比改之前同阶段
- 改善的有
mAP提升约 $0.11\%$NDS提升约 $1.10\%$- 尺寸误差、朝向误差均有所改善
- 相持的有
- 中心定位误差基本不变
- 劣化的有
- 逐类表现不均衡,其中 bus 类型的
AP下降约 $1.50\%$
- 逐类表现不均衡,其中 bus 类型的
为便于横向对比,同样选择 $44k$ 处为起点,尝试降低学习率到 $1E-4$ 并继续训练到 $epoch\ 70$ ,过程如下

选择与类别分组前相同的 checkpoint 进行评估以方便对比,并将结果汇总如下
| step | mAP | traffic cone AP | car AP | barrier AP | pedestrian AP | motorcycle AP | bus AP | bicycle AP | truck AP | trailer AP | construction vehicle AP | NDS | mATE | mASE | mAOE | mAVE | mAAE |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 46,000 | 0.1645 | 0.3093 | 0.4091 | 0.3659 | 0.1273 | 0.0823 | 0.1283 | 0.0540 | 0.0917 | 0.0617 | 0.0156 | 0.2652 | 0.8347 | 0.2980 | 0.6717 | 1.1622 | 0.3659 |
| 50,000 | 0.1652 | 0.3033 | 0.4116 | 0.3735 | 0.1249 | 0.0847 | 0.1331 | 0.0511 | 0.0931 | 0.0619 | 0.0146 | 0.2660 | 0.8296 | 0.2975 | 0.6731 | 1.1615 | 0.3654 |
| 52,000 | 0.1674 | 0.3084 | 0.4101 | 0.3784 | 0.1256 | 0.0835 | 0.1429 | 0.0528 | 0.0941 | 0.0629 | 0.0155 | 0.2687 | 0.8269 | 0.2967 | 0.6642 | 1.1363 | 0.3625 |
| 54,000 | 0.1661 | 0.3071 | 0.4137 | 0.3774 | 0.1249 | 0.0800 | 0.1354 | 0.0508 | 0.0944 | 0.0611 | 0.0164 | 0.2669 | 0.8304 | 0.2978 | 0.6713 | 1.1541 | 0.3623 |
| 60,000 | 0.1644 | 0.3035 | 0.4089 | 0.3743 | 0.1208 | 0.0770 | 0.1352 | 0.0507 | 0.0928 | 0.0653 | 0.0153 | 0.2683 | 0.8242 | 0.2988 | 0.6539 | 1.1460 | 0.3624 |
从结果来看,本次续训中,模型的最佳表现发生在 $52k$ 步,相比分组前的最佳 mAP 提升了 $0.23\%$ 而 NDS 提升了 $0.81\%$ ,取得了小幅收益。从分类 AP 来看,虽然 truck、trailer、car、bicycle 分别提高约 $1.41\%$ 、$1.02%$ 、$0.92%$ 、$0.75%$ ,但 motorcycle 也下降约 $1.69\%$ ,提升存在类别取舍。
261019
验证:添加
Circle NMS
使用 GPT-6.1 Sol 实现一版(48d3f33328983916f745593113cc28d7e2971afc)添加同类中心距离抑制,并比较关闭 NMS 和半径分别为 $0.5m, 1m, 2m$ 的 Circle NMS 在性能上的变化。该试验无需重新训练,在前述 $52k$ 步权重上,保持 score_thresh=0.01 和 topk=500 不变。相关命令参考其仓库的 README 文件。
评估结果如下:
| 设置 | mAP | NDS | mAP 变化 |
|---|---|---|---|
| 无 NMS | 16.7407% | 26.8677% | 基准 |
| 半径 0.5 米 | 16.7404% | 26.8676% | $−0.0002\%$ |
| 半径 1 米 | 16.7596% | 26.8793% | $+0.0189\%$ |
| 半径 2 米 | 16.1310% | 26.7109% | $−0.6097\%$ |
从 mAP 结果来看,简单的 Circle NMS 收益很小。具体来说:
- 0.5 米只删除了约 209 万个候选中的 7 个,基本不起作用
- 1 米略有提升,但不足以成为主要改进方向
- 2 米明显伤害密集类别:barrier、交通锥、行人 AP 分别下降约 $3.94%$、$1.56%$、$1.42%$